我自己做 B2B GTM 与战略营销,平时几乎所有工作流都挂在 LLM 上。大家都在晒各种复杂的 Agent ,但我发现自己真正在主力跑、每天离不开的,其实是一套跑在 MacBook Pro 上的个人 AI 网关。
它现在接管了我本机全部的 LLM 调用——Cursor 、Codex CLI 、Claude Code ,还有我自己的 Agent 内容管线。
为什么要做
2026 年中,我的调用环境彻底失控了:手头十几个模型订阅和 API Key ( DeepSeek 、NVIDIA NIM 、DashScope 、Gemini 等),各个客户端和脚本直连模型,endpoint 写死在代码里。结果就是每个月都在焦虑额度,钱花在哪儿完全是一笔糊涂账。
问题不在模型,在调用失控。我要的其实就三样:
- 一个入口:所有客户端只配一次;
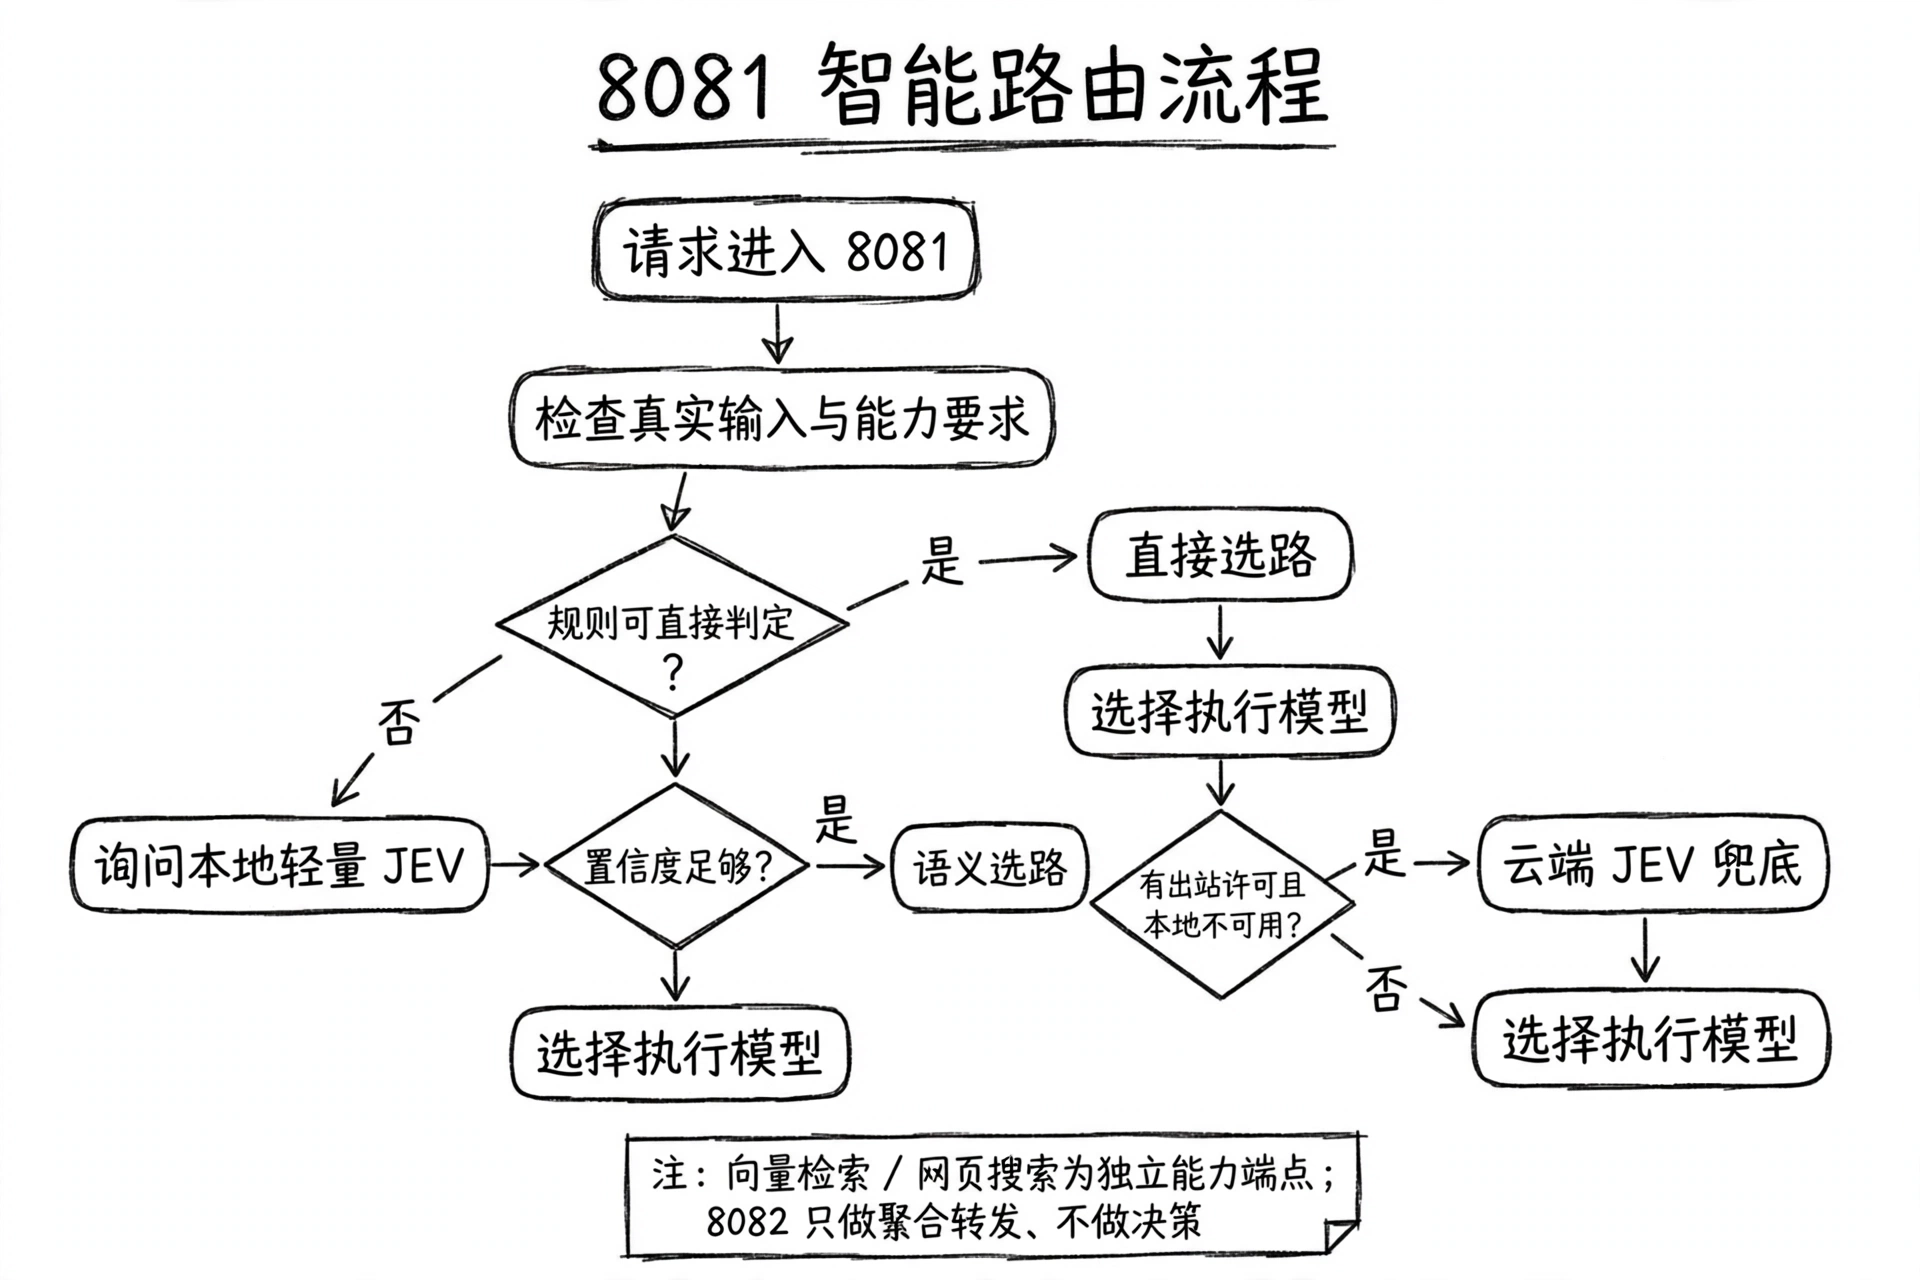
- 路由智能:打杂分诊走便宜的本地小模型,硬骨头再上顶级云端模型;
- 全程可审计:每次调用留痕,哪个渠道挂了随时无感替换。
架构
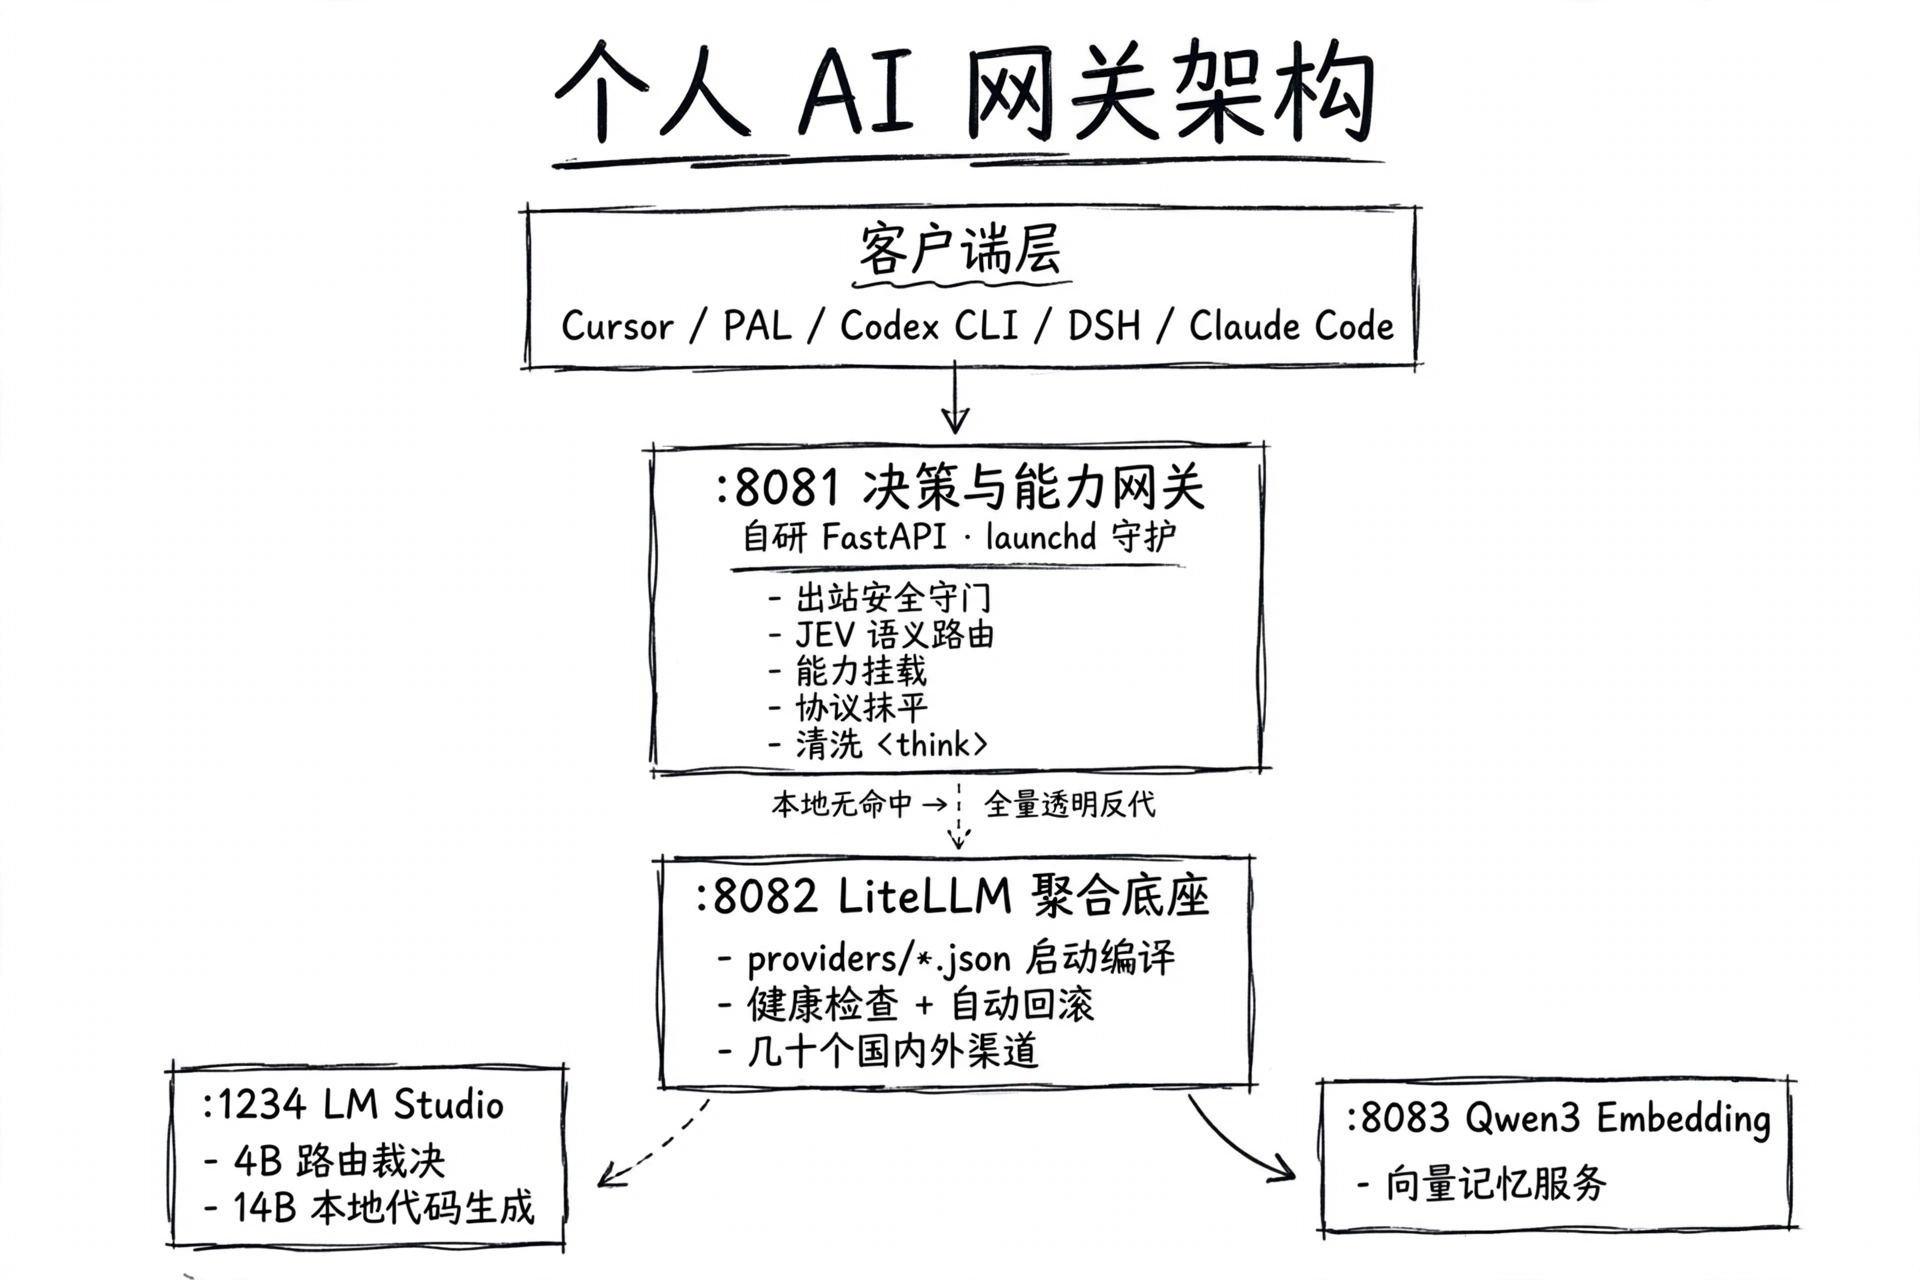
:8081—— 决策网关(自研):FastAPI 服务,launchd守护进程。在请求真正碰到模型之前干五件事:出站安全守门、本地语义路由(判断这次该走哪个模型/渠道)、系统级工具能力挂载、跨渠道协议抹平,以及清洗<think>与reasoning_content(治理 thinking 污染,不让推理过程漏进下游上下文)。如果本地没有命中自研端点,就把请求全量透明反代给:8082。:8082—— 聚合底座:LiteLLM Proxy ,挂着几十个国内外模型渠道( DeepSeek 官方、NVIDIA NIM 、DashScope Coding Plan 、Gemini 等)。渠道配置是声明式的providers/*.json,启动时编译,带健康检查和失败自动回滚。:1234—— 本地模型:LM Studio ,4B 模型做路由裁决,14B 做本地代码生成。:8083—— 本地向量服务:本地 Qwen3 Embedding 向量记忆服务。
8081 路由流程
管我一天的两个别名
平时在各个客户端里,我主要就切这两个模型别名:
hybrid-auto—— 强制本地。分诊、起草、敏感内容不出本机。hybrid-auto-cloud—— 允许云端。硬问题交给顶级云端模型。
另外有一条铁律在网关层强制执行:只走原生 Vision。模型本身不是多模态的,绝不用转换层伪装。
实际运行数据
这套网关不是 Demo ,是我的日常主力。四个客户端每天的所有请求,都要过 :8081 的路由、安全守门和 <think> 清洗,才到得了模型。
我的 Agent 内容管线( LLM API + Python + Agent 工作流)全跑在上面,把我的内容生产周期缩短了 60%,每周产出 30+ 篇 AI 相关内容。2026 年 8 月,仅我个人 DeepSeek 面板单月就有 25,896 次请求、约 17.06 亿 tokens。这个量级如果没有网关收口,基本就是裸奔。
踩过的坑
列一份诚实的踩坑清单:
- 两个端口根路径都是 Swagger UI:我曾花了一个下午排查为什么访问
:8081的根路径会返回:8082LiteLLM 的 Swagger UI ,后来才想起来——未命中路径全量透明反代,是我自己设计的。现在它写进了文档的已知行为,不再是谜。 - 渠道配置静默失败:早期
providers/*.json的编译步骤对畸形渠道配置是静默失败的,导致陈旧路由继续在线。直到有一次坏配置黑洞掉我一晚上的 Agent 任务,我才把启动健康检查和自动回滚加上。 - Thinking 污染:在网关加上
<think>清洗之前,上游模型的推理 trace 会漏进下游 prompt ,用一种很隐蔽、极难追踪的方式拉低输出质量。最后在回调层加了清洗器解决——真正的教训是,多模型串联时居然还有这类隐蔽 bug 。 /capabilities/*端点还在建:核心链路(路由、守门、聚合、清洗)已经稳定跑着,扩展的能力端点面是下一步。先跑起来解决问题,再慢慢补全。
下一步
短期先把能力端点面补完,加上按渠道的单次请求成本归因——“哪个模型值”要用账本数据回答,不用体感。
长期我在看业界怎么把这一层产品化。比如 DeepSeek Harness 团队刚开源了 dsh-superagent( MIT ),事件驱动的 Agent bundle ,思路看起来像我这套个人网关的商业版亲戚。个人网关是个原型,更有意思的问题是:面向团队的托管版应该长什么样?
如果你也在本地跑多客户端、多渠道的 Agent 工作流,建议先做调用审计。你看不见流量的地方,是没法做路由的。欢迎交流各自的网关方案。
 Select Language